AI가 웹에서 직접 일하는 시대
Insight
목차 5
지난 9월 3일 OpenAI가 GPT-6 Astra를 공개했습니다. 이어 22일에는 GPT-6 Sol과 Luna가 추가됐고, 같은 날 Anthropic도 Claude Opus 5.5를 발표했습니다.[1][4][5] 신규 모델들은 복잡한 작업을 수행하는 능력뿐 아니라, 작업에 드는 시간과 비용도 강조하고 있습니다. 이번 호에서는 AI가 웹에서 정보를 찾고 작업하는 능력이 어떻게 달라졌는지 살펴보고, 브랜드 마케터가 GEO에서 점검할 부분을 짚어보겠습니다.
GPT-6 Astra, 무엇이 달라졌을까?
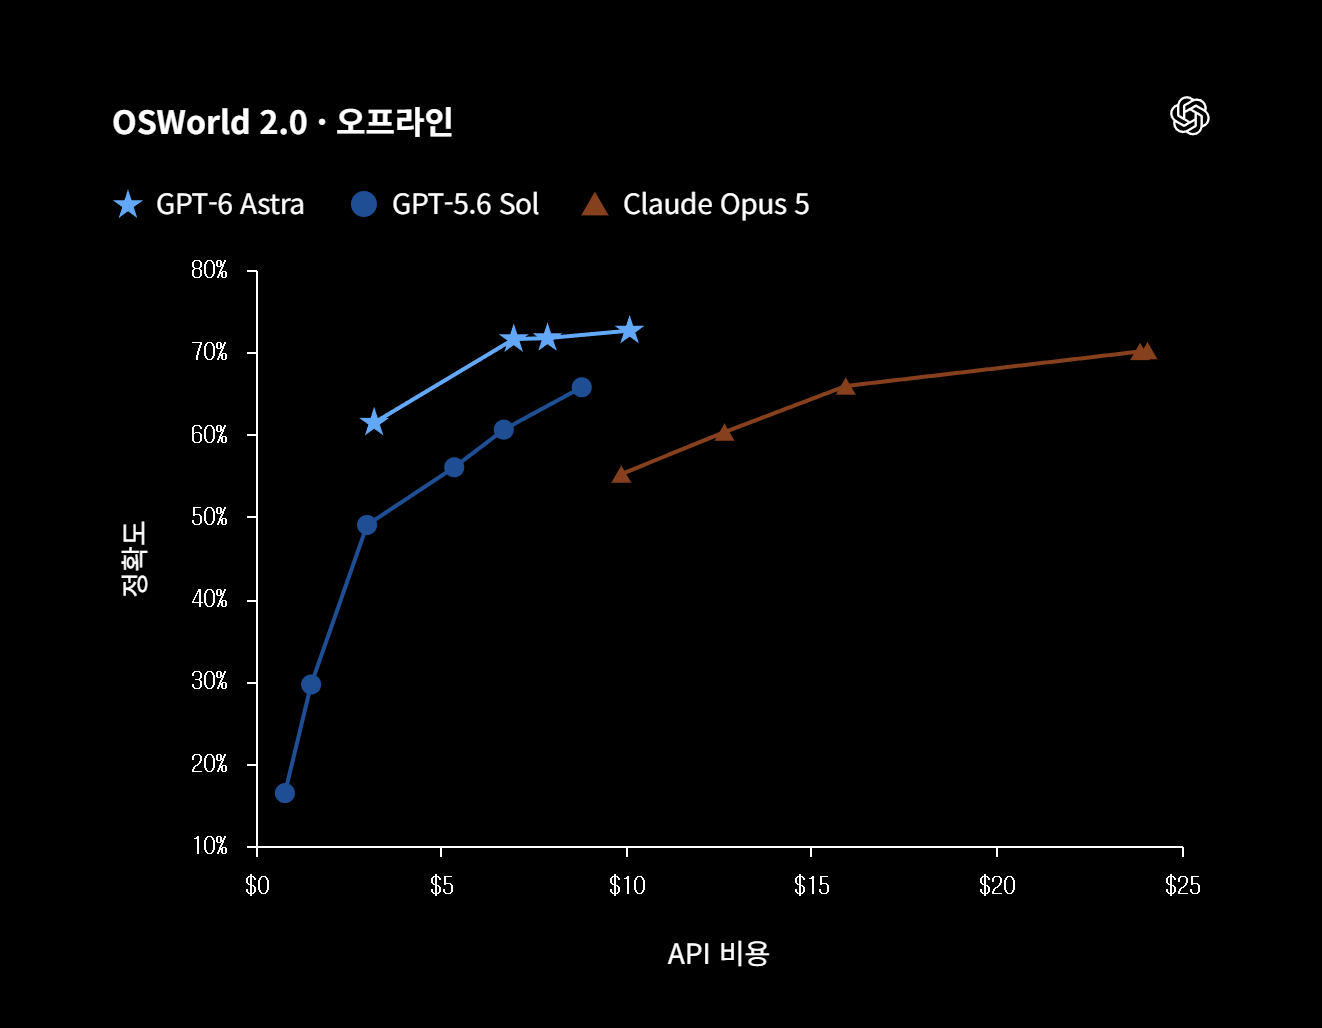
GPT-6 Astra에서 먼저 눈에 띄는 것은 컴퓨터 사용 능력입니다. AI가 화면을 보고 클릭하거나 입력해 작업하는 능력을 평가하는 OSWorld 2.0에서 Astra는 72.6%를 기록했습니다. 이전 모델인 GPT-5.6 Sol의 65.7%보다 높은 점수입니다. 작업당 소요 시간도 평가 환경의 시뮬레이션에서 약 75분에서 40분으로 줄었습니다.[1] 이 평가는 인터넷을 사용하지 않는 환경에서 진행됐으므로, 수치는 Astra가 컴퓨터 작업을 수행하는 능력이 개선됐다는 근거로 읽는 것이 정확합니다.
웹 작업에서도 속도 개선이 보고됐습니다. OpenAI에 따르면 Mind2Web 평가에서 Astra와 새 작업 환경을 함께 사용했을 때, 기존 GPT-5.6 Sol 환경보다 작업 완료 속도가 1.9배 빨랐습니다.[1] 모델 자체의 개선과 작업 환경의 개선이 합쳐진 결과입니다. AI가 웹페이지를 찾아 답하는 데서 그치지 않고, 화면을 조작하며 여러 단계를 거치는 작업을 더 빠르게 마칠 수 있다는 의미입니다.
OpenAI가 소개한 활용 사례도 이런 변화를 보여줍니다. Astra는 온라인으로 자료를 조사하고, 웹 양식을 작성하며, 고객 관리 시스템의 정보를 업데이트할 수 있습니다.[1] 사용자가 목표를 주면 AI가 필요한 정보를 찾아보고, 화면을 조작하고, 결과를 정리하는 식입니다.
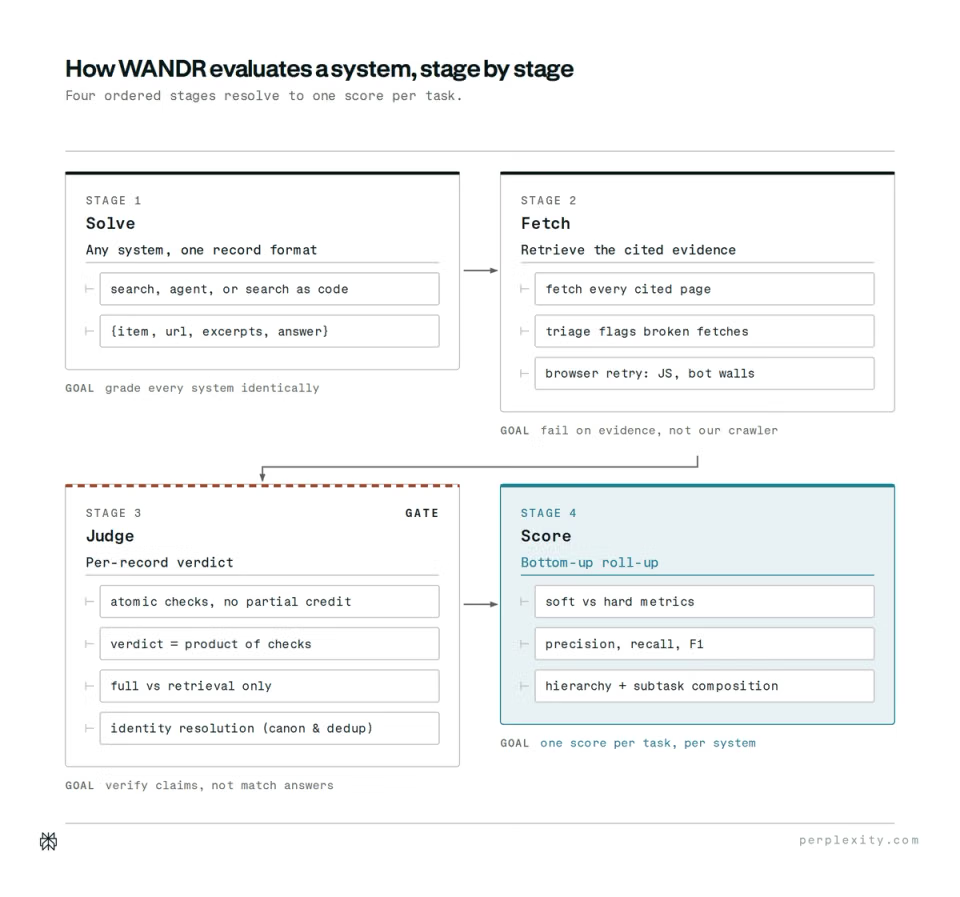
웹 조사 능력을 좀 더 직접적으로 살펴볼 수 있는 평가는 Perplexity의 WANDR입니다. WANDR은 조건에 맞는 대상을 여러 개 찾아내고, 각 대상에 관한 정보를 웹페이지와 인용 구절로 뒷받침하도록 요구합니다. 제품 비교나 경쟁사 조사처럼 처음부터 후보 목록이 정해져 있지 않은 작업과 닮아 있습니다.[2] Perplexity가 GPT-6 Astra로 평가한 결과, Astra는 0.682점을 기록해 당시 비교한 이전 모델들보다 높은 점수를 받았습니다.[3] 이 점수는 조사 작업 전반의 평가 결과입니다.
GPT-6 Sol과 Luna, 성능을 더 낮은 비용으로
Astra 발표 후 추가된 GPT-6 Sol과 Luna는 작업 성능과 비용의 균형에 초점을 맞췄습니다. OpenAI는 Astra 개발에 적용한 개선을 두 모델에도 반영하면서 이전 세대 Sol, Luna보다 API 가격을 낮췄습니다.[4] 복잡한 업무를 여러 번 처리하거나 AI 서비스를 많은 사용자에게 제공할 때는 한 번의 최고 성능만큼 작업당 비용도 중요하기 때문입니다.
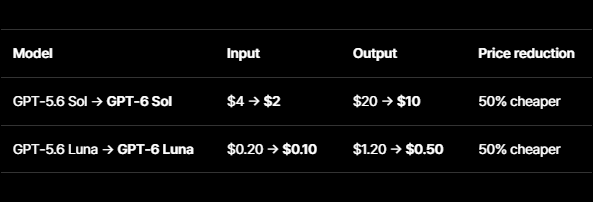
Sol은 복잡한 작업을 비교적 낮은 비용으로 수행하는 선택지입니다. 여러 앱의 도구를 사용해 업무를 완료하는 AutomationBench에서 GPT-6 Sol은 높은 추론 설정 기준 33.2%를 기록했습니다. OpenAI의 자체 사실 정확성 평가에서는 이전 Sol 모델보다 오류가 약 절반으로 줄었습니다.[4] Luna는 비용에 더 민감한 작업을 위한 모델입니다. 같은 AutomationBench에서 이전 Luna 모델보다 점수가 5.4%포인트 높으면서 작업당 비용은 58% 낮았습니다.[4]
세 모델의 역할은 이렇게 이해할 수 있습니다. Astra는 가장 어려운 작업에, Sol은 성능과 비용을 함께 고려해야 하는 작업에, Luna는 많은 양을 반복해서 처리해야 하는 작업에 맞춘 모델입니다. 신규 모델 발표의 의미는 최고 성능의 AI 한 종류가 나온 데서 끝나지 않습니다. 작업의 난도와 규모에 따라 선택할 수 있는 범위도 넓어졌습니다.
Claude Opus 5.5, 찾기 어려운 자료까지 확인한다
Claude Opus 5.5에서도 자료 조사 능력의 개선이 눈에 띕니다. Anthropic은 기업의 실적 발표 자료를 찾기 어려운 웹 환경을 만들고, 모델에 분기 실적 보고서를 작성하게 했습니다. 이후 보고서에 쓰인 수치와 인용문이 실제 자료와 맞는지 검사했습니다. Opus 5.5는 여러 설정에서 작성한 보고서 18개 중 16개가 기준을 통과했습니다. 함께 시험한 이전 Claude 모델인 Fable 5.1과 Opus 5는 통과한 보고서가 없었습니다.[5] 한 가지 내부 테스트이지만, 찾기 어려운 원자료를 확보하고 보고서의 내용과 대조하는 작업에서 나타난 차이를 보여줍니다.
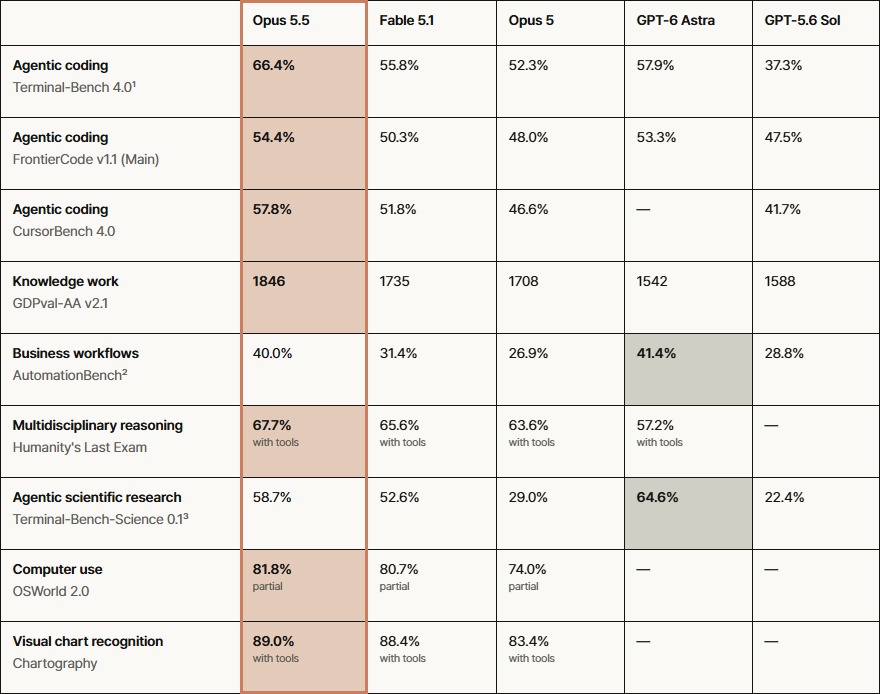
Anthropic은 Opus 5.5가 WANDR 평가에서도 이전 Claude 모델들보다 좋은 결과를 더 낮은 작업당 비용으로 얻었다고 발표했습니다.[5] 다만 Anthropic은 오프라인 웹 검색 도구를 사용하는 자체 평가 환경에서 모델들을 비교했습니다. 따라서 이 결과와 Perplexity가 발표한 Astra의 0.682점을 나란히 놓고 어느 모델이 더 우수하다고 판단할 수는 없습니다.[3][5]
시간과 비용 면에서도 개선이 있습니다. Anthropic에 따르면 Opus 5.5는 일반적인 작업에서 Opus 5보다 비용이 약 40% 낮고, 출력 생성 속도는 30% 이상 빠릅니다.[5] 여기서 출력 생성 속도는 모델이 답변을 만들어 내는 속도입니다. 웹 조사를 포함한 모든 작업이 30% 빨리 끝난다는 뜻은 아니지만, 여러 단계를 수행하는 서비스에서 효율을 높이는 변화입니다.
웹을 읽고 직접 작업하는 AI에는 보안도 중요합니다. 웹페이지에 AI의 행동을 바꾸려는 지시를 숨겨 넣는 공격을 프롬프트 인젝션이라고 합니다. OpenAI는 Astra가 GPT-5.6 Sol보다 이런 공격에 강해졌다고 밝혔습니다.[6] Anthropic도 웹 탐색을 포함한 환경에서 Opus 5.5의 대응력을 시험했고, 이전 Opus 모델보다 개선됐다고 발표했습니다.[5] 두 회사 모두 AI가 웹의 정보를 활용하면서 웹페이지에 적힌 지시를 사용자의 요청으로 잘못 받아들이지 않도록 개선하고 있습니다.
앞으로의 GEO는 무엇을 살펴봐야 할까?
이번 평가들을 함께 보면, 신규 모델은 여러 대상을 조사하고 찾기 어려운 자료까지 확인하는 작업에서 개선된 모습을 보입니다. 이를 브랜드 탐색에 적용하면 점검할 질문도 넓어집니다. 소비자가 브랜드명을 직접 말하지 않고 제품군, 사용 목적, 가격대나 경쟁 제품을 기준으로 질문할 때 우리 브랜드가 후보로 발견되는지 살펴보는 것입니다. 신규 모델이 실제 소비자 대상 AI 검색에서 더 많은 브랜드를 추천한다는 뜻은 아닙니다. 평가에서 확인된 조사 능력을 바탕으로 앞으로 확인해 볼 지점을 정한 것입니다.
함께 점검할 것은 웹에 있는 브랜드 정보의 범위와 일관성입니다. 공식 사이트뿐 아니라 판매처와 비교 콘텐츠 등에서 우리 브랜드가 어떤 맥락으로 소개되는지, 제품명, 특징, 가격 같은 핵심 정보가 서로 맞는지 확인해야 합니다. 브랜드 이름을 많은 페이지에 반복하기보다, 소비자의 서로 다른 질문을 따라 조사했을 때 우리 브랜드를 발견할 수 있는지, 발견한 자료들이 서로 다른 설명을 내놓지는 않는지 살펴보자는 것입니다.
함께 점검할 것은 웹에 퍼져 있는 브랜드 정보의 범위와 일관성입니다. 공식 사이트뿐 아니라 판매처와 비교 콘텐츠 등에서 우리 브랜드가 어떤 맥락으로 소개되는지, 제품명, 특징, 가격 등 핵심 정보가 서로 다르지 않은지 확인하는 겁니다. 목표는 브랜드 이름을 가능한 많은 페이지에 반복하는 것이 아닙니다. AI가 소비자의 서로 다른 질문을 따라 조사하더라도 우리 브랜드를 발견하고, 여러 자료에서 서로 맞는 정보를 확인할 수 있는 웹 환경을 만드는 것입니다.
지금 확인된 것 | 앞으로 확인해야 할 것 |
|---|---|
Astra는 컴퓨터, 웹 작업에서 이전 모델보다 높은 성능을 기록했고, WANDR의 여러 대상 조사 평가에서도 좋은 결과를 냈습니다.[1][2][3] | 실제 소비자의 제품 탐색 요청에서도 브랜드 후보의 범위가 달라지는가? |
Opus 5.5는 찾기 어려운 자료를 조사하고 보고서의 수치와 인용문을 확인하는 테스트에서 이전 모델보다 좋은 결과를 냈습니다.[5] | 여러 웹 출처에서 발견된 브랜드 정보 가운데 무엇이 최종 답변에 반영되는가? |
Sol·Luna와 Opus 5.5는 성능과 함께 작업 비용도 개선했습니다.[4][5] | 이 모델들을 적용한 서비스에서 여러 단계를 거치는 조사 작업이 어떻게 활용되는가? |